Ein Knowledge Panel ist die rechts oder oberhalb der Suchergebnisse eingeblendete Entitätskarte, die Google aus seinem Knowledge Graph generiert, sobald eine Person, Marke oder Organisation als eindeutig identifizierbare Entität mit hinreichender Vertrauensbasis gilt. Es ist kein Ranking-Produkt, sondern eine strukturelle Repräsentation. Laut Google-Hilfe wird es automatisch generiert, aus Daten von Partnern, offenen Webquellen und Änderungsvorschlägen verifizierter Entitäten. Praktisch heißt das: Mehrere unabhängige Quellen, strukturierte Daten und autoritative Referenzen müssen dieselben Fakten bestätigen.
Dieser Beitrag verschiebt die Perspektive. Weg von der populären Frage „Wie bekomme ich ein Knowledge Panel?", hin zur strategisch tragfähigen Frage: Wie baue ich eine Entität auf, die Google nicht anders kann, als sie im Graph zu repräsentieren? Grundlage sind Googles offizielle Hilfeseiten, die Regeln von Wikidata und Wikipedia sowie eigene Beobachtungen aus einer zweistelligen Zahl an Personal-Brand- und Organisations-Projekten. Eigene Beobachtungen sind im Text als solche gekennzeichnet.
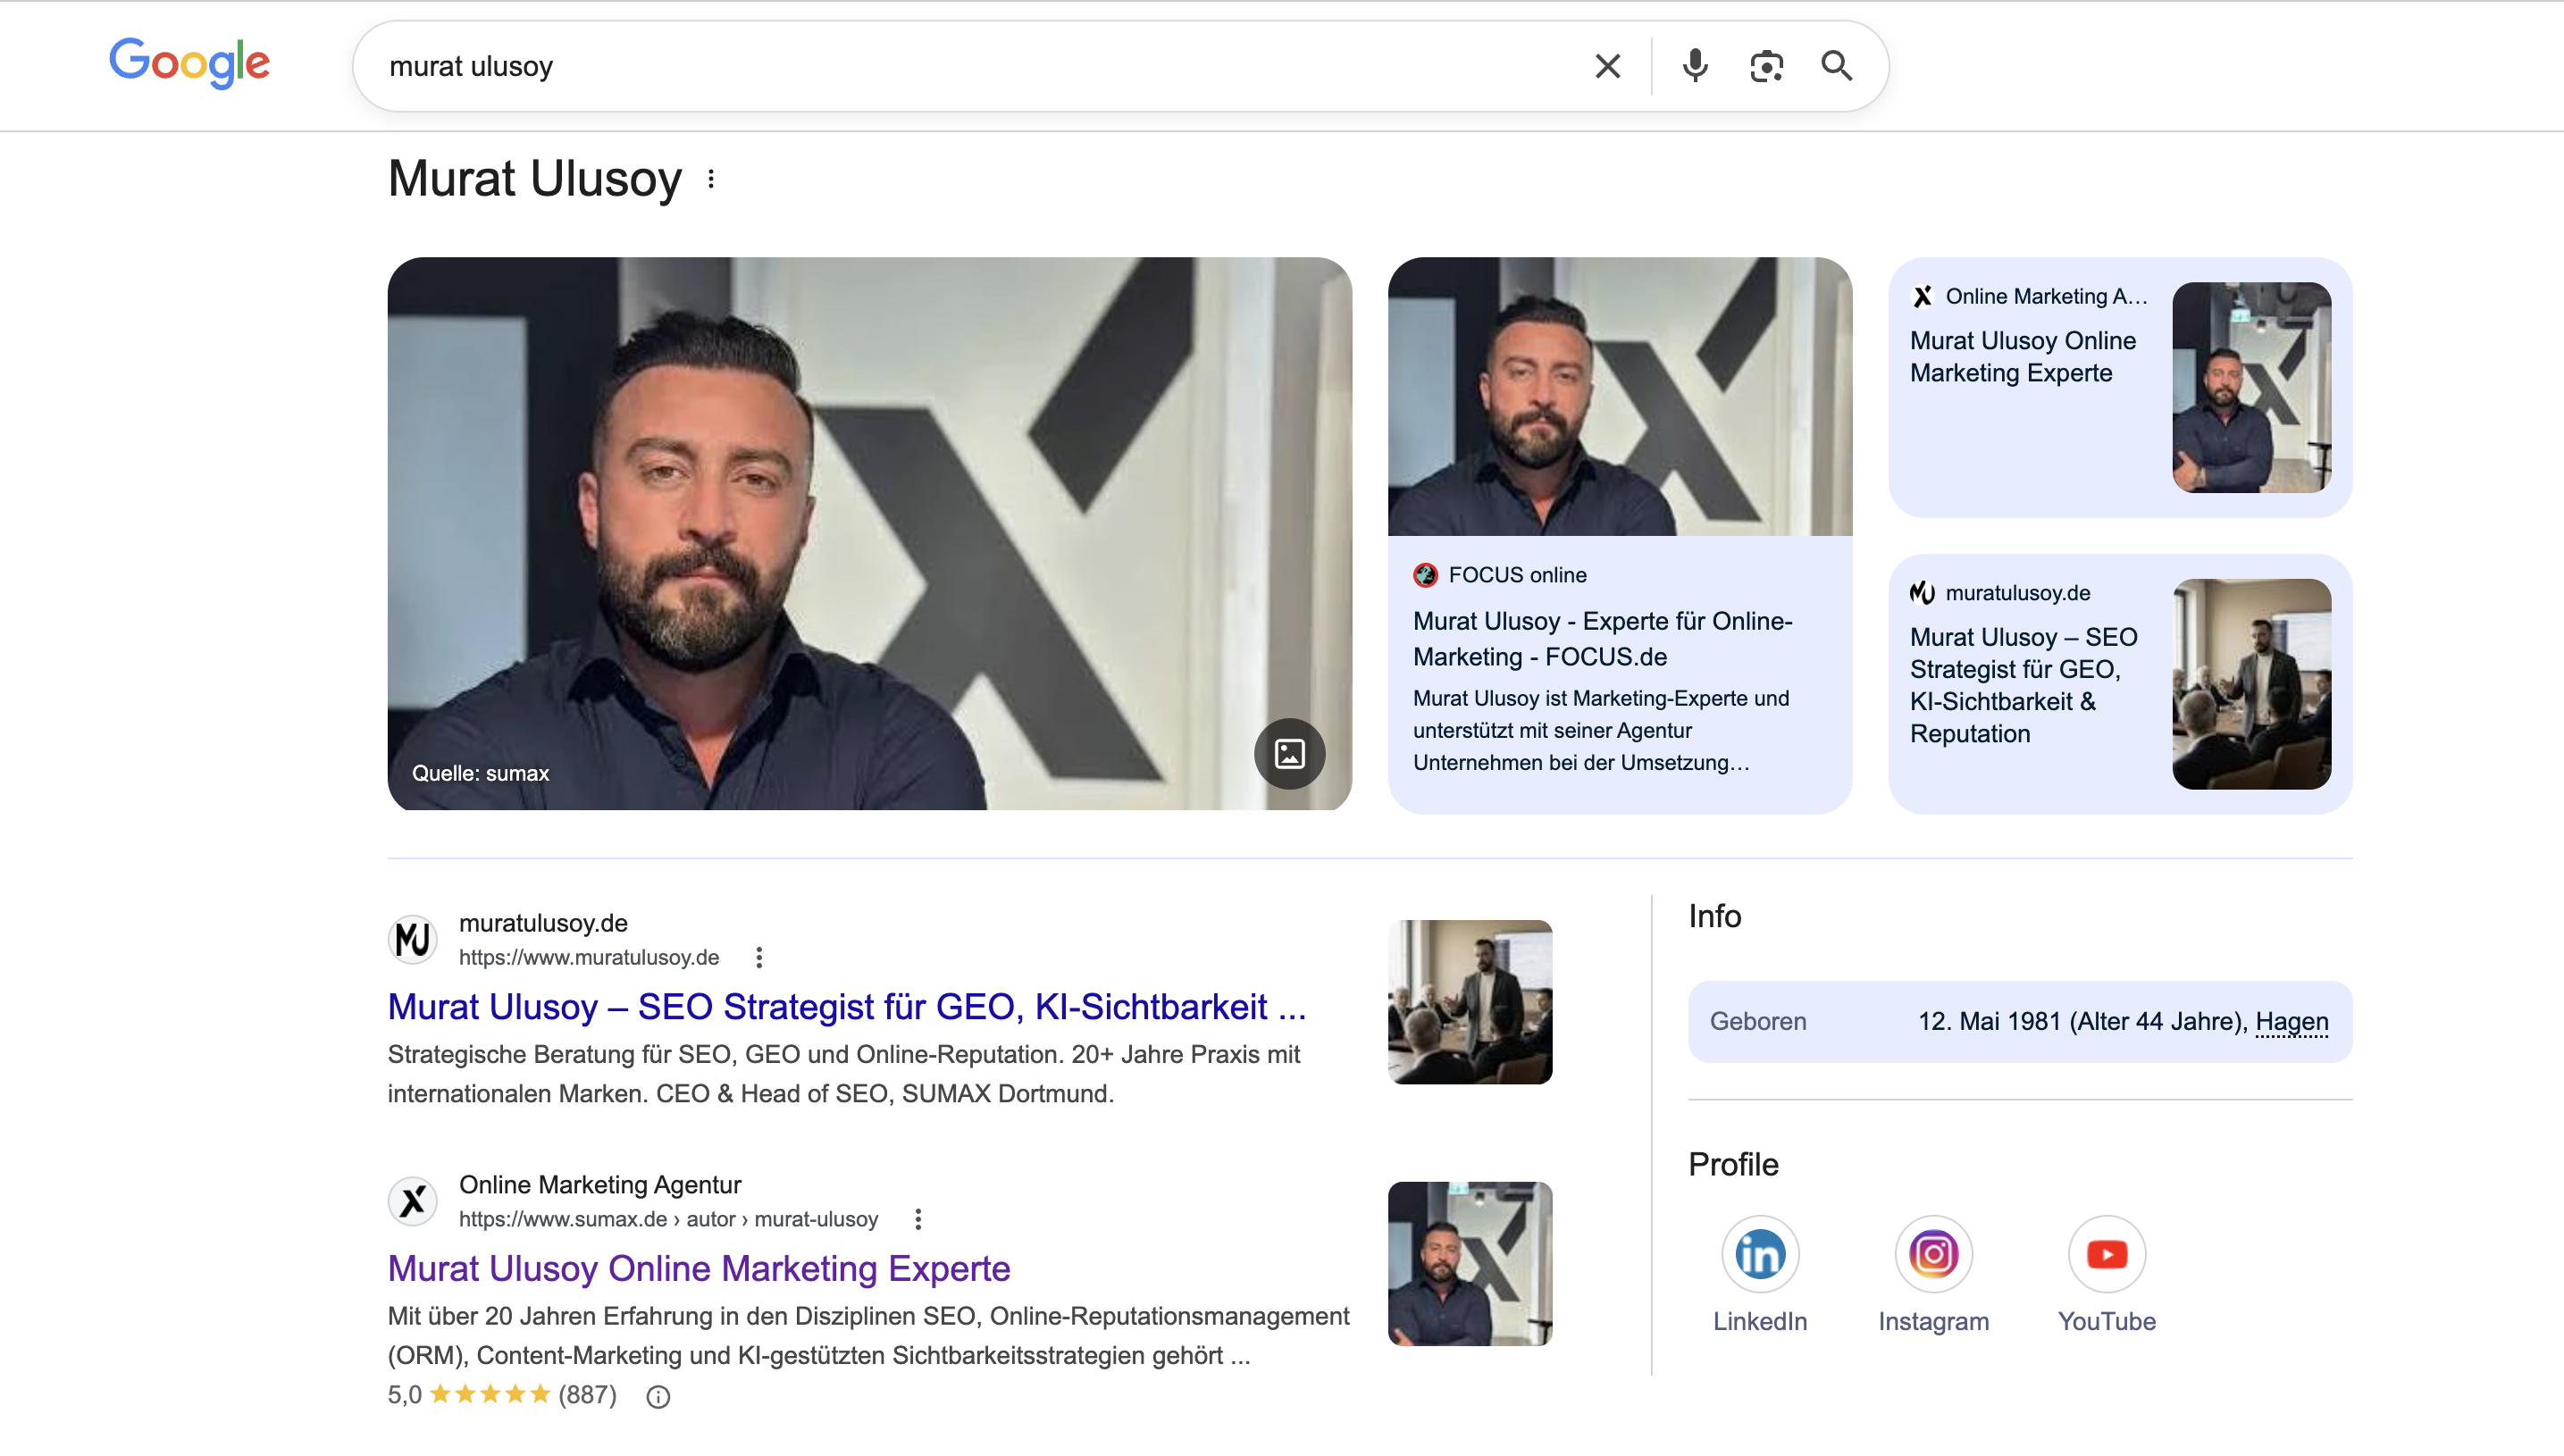
Die falsche Frage: „Wie bekomme ich ein Knowledge Panel?"
Die Frage ist populär, aber sie beschreibt einen kategorischen Fehlschluss. Sie behandelt das Panel wie eine Platzierung, die man kaufen, lobbyieren oder technisch erzwingen kann. In Wahrheit ist ein Knowledge Panel das Ergebnis eines Schwellenwerts: Google entscheidet nicht „ob diese Person ein Panel verdient", sondern „ob die Entität in meinem Graph eindeutig genug ist, um sie dem Nutzer anzuzeigen". Das sind zwei völlig unterschiedliche Prüfmechanismen.
Die Konsequenz: Alle Maßnahmen, die direkt auf das Panel zielen (gekaufte Wikipedia-Artikel, Fake-PR mit Boilerplate-Wiederholungen, koordinierte Profil-Schwärme), adressieren das Symptom, nicht die Ursache. In der Beratungspraxis mit Führungskräften aus DACH und international haben Panels, die durch solche Shortcuts entstanden sind, regelmäßig innerhalb eines überschaubaren Zeitraums Korrekturen, Inhaltsverluste oder vollständige Löschungen erfahren. Die eigentliche Panel-Frage ist eine Entity-Frage.
Knowledge Panels werden laut Google automatisch generiert; beanspruchen lässt sich nur ein bereits vorhandenes Panel
offizielle Konten zur Verifizierung beim Beanspruchen: YouTube, Search Console, X/Twitter, Facebook (Google-Hilfe)
Monate bis zur Panel-Emergenz in unseren Projekten mit sauberer Entity-Arbeit (eigene Beobachtung, keine Garantie)
Was ist ein Knowledge Panel, und wie entsteht es?
Ein Knowledge Panel (in der deutschen Google-Hilfe „Infobox“) ist ein Informationsfeld in der Google-Suche, das eine Person, Organisation, einen Ort oder ein Werk kompakt zusammenfasst. Google erzeugt es laut eigener Hilfeseite automatisch aus dem Knowledge Graph, gespeist von Datenpartnern, offenen Webquellen und Änderungsvorschlägen verifizierter Entitäten. Einen Antrag auf ein Panel sieht Googles Hilfe nicht vor.
Wer bereits ein Panel hat, kann es beanspruchen: Die Verifizierung läuft über ein offizielles Konto wie YouTube, Search Console, X/Twitter oder Facebook, danach lassen sich Änderungen vorschlagen. Nicht jedes Panel ist laut Google schon beanspruchbar, und lokale Unternehmen nutzen stattdessen ihr Google-Unternehmensprofil. Alle anderen senden Feedback über den Link am Panel. Ob überhaupt ein Panel erscheint, hängt davon ab, wie eindeutig und widerspruchsfrei Google die Entität aus unabhängigen Quellen, strukturierten Daten und Profilen bestätigen kann. Wikipedia und Wikidata können helfen, sind aber keine offizielle Voraussetzung. Garantieren kann ein Knowledge Panel niemand.
Technisch ist ein Panel kein Dokument und keine Seite, sondern eine Projektion aus dem Google Knowledge Graph in das SERP-Template. Im Graph existiert ein Knoten mit einer ID (ältere Entitäten tragen eine aus Freebase stammende MID wie /m/02_286, neuere eine kgmid), die auch die Knowledge Graph Search API zurückgibt. Er ist verknüpft mit Attributen (Name, Beruf, Geburtsdatum, Organisation) und Kanten (sameAs-Relationen, Autorenschaft, Teilhabe). Google startete den Knowledge Graph 2012 laut Ankündigung unter anderem mit Daten aus Freebase, Wikipedia und dem CIA World Factbook.
Unsere Arbeitshypothese, die Google so nicht dokumentiert: Erst wenn die Konfidenz über einen internen Schwellenwert steigt und die Entität gleichzeitig für eine Query relevant genug ist, wird das Panel gerendert. Die beiden Bedingungen sind unabhängig: Eine stabile Entität ohne Query-Demand bleibt unsichtbar. Eine Entität mit hoher Query-Nachfrage, aber unsicheren Attributen, wird nicht ausgespielt - Google vermeidet Falschaussagen in hochprominenten SERP-Slots.
Symptom versus Ursache
Diese Unterscheidung ist operativ zentral. Wer ein Knowledge Panel bekommen möchte, muss die Ursache bearbeiten - den Graph-Knoten. Wer den Output bearbeitet, etwa über das Google-Feedback-Formular das falsche Foto korrigiert, kann das Symptom pflegen, aber die Entität nicht erzeugen. Operativ heißt das: Structured Data, Authority-Signale und Corroboration sind Ursache. Das Panel selbst ist Reporting.
Warum Google konservativ ist
Der Knowledge Graph ist die Vertrauensinfrastruktur hinter AI Overviews, Gemini-Antworten, Featured Snippets und sprachgesteuerten Assistenten. Jeder Fehler multipliziert sich über Dutzende Produkte. Deshalb bevorzugt Google fehlende Panels gegenüber falschen Panels. Die Schwelle liegt nicht bei „ausreichend plausibel", sondern bei „mehrfach belegt und widerspruchsfrei".
Die drei Signalklassen: Corroboration, Authority, Structured Data
| Signalklasse | Was Google prüft | Beispiele für starke Signale | Typische Schwächen |
|---|---|---|---|
| Corroboration | Konsistenz der Kernfakten über unabhängige Quellen | Gleicher Name, Titel, Firma auf Website, LinkedIn, Crunchbase, Press | Abweichende Titel („Founder" vs. „CEO"), inkonsistente Schreibweisen |
| Authority | Renommee der bestätigenden Quellen | Wikipedia, Forbes, Fachzeitschriften, Berufsverbände, ORCID | Blog-Netzwerke, PR-Wire-Only-Mentions, Gastbeiträge ohne Redaktion |
| Structured Data | Maschinenlesbare Entity-Definition | Schema Person/Organization mit vollständigem sameAs |
Fehlendes @id, broken sameAs, Schema nur auf About-Seite |
Alle Entity-Trust-Signale lassen sich in drei Klassen gruppieren. Jede Klasse ist notwendig, keine ist allein hinreichend. Eine starke Authority ohne Corroboration erzeugt Misstrauen. Saubere Structured Data ohne externe Bestätigung erzeugen einen leeren Knoten. Corroboration ohne autoritative Ankerpunkte bleibt Noise.
Corroboration - die Fakten-Übereinstimmung
Corroboration ist die mehrfach unabhängige Bestätigung derselben Fakten. Die Prüffrage lautet etwa: Wird der Name „Murat Ulusoy" auf mehreren unabhängigen Quellen (unsere Faustregel: drei bis fünf) mit identischer Rolle, Firma und Tätigkeit genannt? Die Konsistenz von NAP-Daten (Name, Address, Phone) auf 7-10 kuratierten, wirklich autoritativen Profilen ist der minimale Fingerabdruck, aus dem Corroboration entsteht — Qualität vor Menge.
Authority - die Quellen-Hierarchie
Nicht alle Quellen zählen gleich. Wikipedia, große Publikumsmedien (FAZ, SZ, Handelsblatt, Spiegel), etablierte Fachpublikationen (t3n, iBusiness, Search Engine Land) und wissenschaftliche Datenbanken wiegen ein Vielfaches eines beliebigen Branchen-Profils. Authority-Signale sind der Grund, warum rein profile-basierte Strategien stagnieren. Der Graph braucht Ankerpunkte mit redaktioneller Prüfung.
Structured Data - die Maschinenlesbarkeit
Die dritte Klasse ist die, in der die meisten operativen Fehler passieren. Person- und Organization-Schema mit vollständigem sameAs-Block auf der eigenen Domain ist Pflicht. Ohne diesen Block muss Google die Entität durch Inferenz aus Klartext rekonstruieren - eine Quelle ständiger Entity-Drift. Mit sauberem Schema sinkt der Inferenz-Aufwand, und die Konfidenz steigt.
kuratierte, autoritative Profile mit NAP-Konsistenz als Corroboration-Basis (Faustregel aus unserer Praxis)
unabhängige, seriöse Quellen: Diese Größe nennt auch das Wikidata-Essay zu Self-Promotion als Orientierung
Löschrisiko für Panels und Einträge, die auf gekauften oder koordinierten Signalen beruhen (eigene Beobachtung)
Der systematische Fehler: Panel-Hacking
Panel-Hacking beschreibt den Versuch, über gekaufte PR, koordinierte Profil-Netzwerke, bestellte Wikipedia-Edits oder manipulative Structured-Data-Injektionen ein Knowledge Panel zu erzwingen. Die Technik funktioniert gelegentlich - kurzfristig. In unserer Beratungspraxis haben wir beobachtet, dass die deutliche Mehrheit dieser Panels über einen mittleren Zeitraum wieder verschwindet oder beschnitten wird. Unsere Erklärung: Statistisch unnatürliche Corroboration-Muster fallen auf. Bei Wikipedia kommt eine Regel hinzu: Wer für Beiträge bezahlt wird, muss Auftraggeber und Zugehörigkeit laut Wikimedia-Nutzungsbedingungen offenlegen.
Typische Signaturen, die wir in Audits sehen: identische Biografie-Boilerplates über 20+ Profile innerhalb von zwei Wochen, plötzliche Verlinkung aus koordinierten Autoren-Accounts, Wikipedia-Artikel mit nicht-notable Sourcing, das kurz nach Veröffentlichung von Deletionist-Editoren markiert wird. Jedes dieser Muster ist ein Signal - und in Kombination ein eindeutiges.
Der Delete-Penalty-Effekt
Ein gelöschtes Panel ist schwerer wieder aufzubauen als ein nie erschienenes. Re-Entries nach einer Panel-Deletion verlängern die Aufbauzeit typischerweise deutlich und erfordern zusätzliche Authority-Investitionen in der Größenordnung des ursprünglichen Aufbaus, so unsere Beobachtung. Google dokumentiert dazu nichts öffentlich; plausibel ist, dass widersprüchliche oder entfernte Quellen die Konfidenz länger belasten. Für CMOs bedeutet das: Die günstigste Abkürzung ist die teuerste Langzeit-Option.
„Ein Knowledge Panel ist keine Belohnung für Marketing-Anstrengung. Es ist der nüchterne Ausdruck der Tatsache, dass eine Entität in Googles Weltmodell existiert - konsistent, überprüfbar und ohne Widerspruch."
Warum Shortcuts ökonomisch irrational sind
Angebote für Panel-Abkürzungen liegen nach unseren Marktbeobachtungen oft im vier- bis fünfstelligen Bereich, bei erwartbar kurzer Haltedauer. Entity-Trust-Arbeit liegt bei vergleichbaren oder niedrigeren Summen an Eigenzeit plus gezieltem PR-Invest, mit einer erwartbar vielfach längeren Haltedauer und sekundären Effekten auf AI-Citation-Rate, Branded-Search und LLM-Reputation. Der Unterschied ist nicht 2x oder 5x. Er ist strukturell.
Entity-Trust als System: das 6-Schicht-Modell
Wir arbeiten mit einem geschichteten Modell, das die Konfidenzbildung von Google nachvollziehbar zerlegt. Jede Schicht ist notwendig; fehlt eine, bleibt der Score unter der Panel-Schwelle. Der Gesamt-Score ergibt sich als gewichtete Summe:
EntityTrust = (0.25 × Identity)
            + (0.20 × Corroboration)
            + (0.20 × Authority)
            + (0.15 × StructuredData)
            + (0.10 × Consistency)
            + (0.10 × Notability)

Panel-Schwelle (Arbeitswert aus unserer Praxis, kein Google-Wert): EntityTrust ≥ 0,72

Schichten:
Identity        = Eindeutige Namens-Disambiguation, Collision-Score
Corroboration   = Fakten-Übereinstimmung über unabhängige Quellen
Authority       = Quellen-Hierarchie-Gewicht (Wiki/FAZ/Fachmedien)
StructuredData  = Schema.org Person/Org + sameAs-Vollständigkeit
Consistency     = NAP-Übereinstimmung auf den kuratierten Kernprofilen
Notability      = Wikidata-Notability-Kriterien erfüllt
Die Gewichtung ist unsere eigene Kalibrierung aus der Beratungspraxis, also ein Modell und keine von Google bestätigte Formel. Sie ist ein Operator-Werkzeug: Sie zwingt Teams, an allen sechs Schichten zu arbeiten, nicht nur an den sichtbaren zwei.
Wo die meisten Projekte scheitern
- Identity: unterschätzter Name-Collision-Score, keine Disambiguation-Strategie.
- Notability: Wikidata-Notability-Kriterien nicht erfüllt, daher kein Eintrag, daher kein Fundament.
- StructuredData: sameAs-Block unvollständig oder mit toten URLs.
- Consistency: NAP-Daten auf älteren Profilen nicht nachgepflegt; Entity-Drift bleibt unerkannt.
Schema.org-Implementierung: Person + sameAs richtig aufgebaut
Der E-E-A-T-relevante technische Hebel ist ein konsistentes Person-Schema auf der Hauptdomain der Entität, eingebettet als JSON-LD, mit einem sameAs-Block, der alle autoritativen Profile konsolidiert. Reihenfolge und Auswahl sind nicht beliebig: LinkedIn, Wikidata (als Q-ID-URL, nur wenn ein regelkonformes Item existiert), Wikipedia (wenn vorhanden), Crunchbase, GitHub (bei technischen Profilen), ORCID (bei Wissenschaft), Unternehmens-Profil-Seite.
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Person",
  "@id": "https://www.example.com/#person",
  "name": "Max Muster",
  "alternateName": "Dr. Max Muster",
  "jobTitle": "CEO & Head of Strategy",
  "worksFor": {
    "@type": "Organization",
    "@id": "https://www.example.com/#org",
    "name": "Beispiel GmbH"
  },
  "url": "https://www.example.com/",
  "image": "https://www.example.com/images/max-muster.jpg",
  "sameAs": [
    "https://www.linkedin.com/in/maxmuster/",
    "https://www.wikidata.org/wiki/Q123456789",
    "https://de.wikipedia.org/wiki/Max_Muster",
    "https://www.crunchbase.com/person/max-muster",
    "https://orcid.org/0000-0000-0000-0000"
  ]
}
</script>
Drei typische Fehler sehen wir in der Mehrheit unserer Audits. Erstens: sameAs-URLs führen auf Redirect-Ketten oder 404s - jeder tote Link ist ein Vertrauensabzug. Zweitens: Das Schema existiert nur auf der Startseite, nicht auf einer dedizierten Personenseite mit @id-Anker. Drittens: alternateName fehlt, obwohl die Entität unter Variationen bekannt ist (akademische Titel, Kurzformen, alternative Schreibweisen).
Wikidata als Fundament, und seine Fallstricke
Wikidata ist eine offene, maschinenlesbare Wissensdatenbank. Anders als Wikipedia besteht sie aus Entitäten (Q-IDs) mit typisierten Properties. Die Nähe zu Google ist historisch belegt: Google hat ab 2014 die Inhalte seiner Datenbank Freebase an Wikidata übergeben (Pellissier Tanon et al., 2016). Wie stark Google Wikidata heute gewichtet, dokumentiert Google nicht. Wer ein Knowledge Panel verifizieren möchte, nutzt den offiziellen Claim-Prozess von Google; ein regelkonformes Wikidata-Item kann die Faktenbasis zusätzlich festigen.
Die zentrale Hürde heißt Notability. Laut Wikidata:Notability ist ein Item zulässig, wenn es mindestens ein Kriterium erfüllt: einen gültigen Sitelink zu einem Wikimedia-Projekt, eine klar identifizierbare Entität, die sich mit seriösen, öffentlich zugänglichen Quellen beschreiben lässt, oder einen strukturellen Bedarf. Das Essay Wikidata:Self-promotion rät ausdrücklich davon ab, Items über sich selbst oder die eigene Organisation anzulegen, und nennt drei unabhängige, seriöse Quellen als Orientierung. Wer diese Belege nicht hat, riskiert einen Request for Deletion.
Property-Hygiene
Ein technisch guter Wikidata-Eintrag pflegt mindestens: P31 (instance of), P106 (occupation), P1416 (affiliation), P856 (official website), P2002 (X/Twitter), P2037 (GitHub) und, kritisch, Referenzen pro Property zu externen Quellen. Ein Wikidata-Eintrag ohne Referenzen ist ein Eintrag auf Abruf.
Sprach-Labels
Für internationale Entitäten sind mehrsprachige Labels und Descriptions keine Kür. Ein konsistentes de-, en-, tr-, fr-Label erhöht die Chance, dass Google die Entität marktübergreifend als identisch erkennt und nicht als getrennte Entities pro Sprachraum modelliert.
| Dimension | DIY-Ansatz | Professionell begleitet |
|---|---|---|
| Zeitaufwand (Auftraggeber) | 40-100 h über 3-12 Monate | 2-4 h Onboarding, dann Monitoring |
| Technisches Skill-Niveau | Schema-Markup, Wikidata-Syntax, SEO-Fundamentals | Keines - extern abgedeckt |
| Wikidata-Notability-Risiko | Hoch - Notability-Ablehnung häufig | Geringer, weil Notability vorab geprüft wird (bezahlte Mitarbeit offenlegen) |
| PR-Qualität | Variabel, oft PR-Wire-only | Redaktionelle Fachmedien, verifiziert |
| Typische Panel-Zeit | oft 6-12 Monate, unsicher | oft 3-6 Monate, ohne Garantie |
| Fehlerrisiko | Moderat bis hoch | Niedrig, dokumentiert |
| Kostenspanne | Selbstkosten + 3-10 T€ PR extern | 3-15 T€ projektabhängig |
Wann erscheint ein Knowledge Panel, und wann nicht?
Ein Panel erscheint erst, wenn Google die Entität eindeutig zuordnen kann und genügend Suchen nach ihr stattfinden. Unsere Beobachtung aus Beratungsprojekten (eigene Daten, keine repräsentative Stichprobe): Panels erschienen meist 2 bis 6 Wochen nach dem Moment, in dem die Entity-Trust-Schwelle überschritten wird - aber nur, wenn parallel eine ausreichende Query-Nachfrage existiert. Ohne Suchvolumen auf den Namen bleibt die Entität im Graph präsent, aber ohne SERP-Projektion.
Zudem beobachten wir Konstellationen, in denen trotz starker Signale lange kein Panel erscheint: Minderjährige, Personen mit laufenden rechtlichen Verfahren, Entitäten mit Reputations-Streitigkeiten und Personen in regulierten Branchen (Finanz, Medizin, Recht). Google dokumentiert dafür keine festen Regeln; wir vermuten höhere Qualitätsanforderungen bei YMYL-Themen.
Reihenfolge schlägt Tempo
In unseren Projekten wurden Panels am schnellsten sichtbar, wenn unabhängige Berichterstattung und vollständiges Schema bereits standen, bevor strukturierte Einträge wie ein Wikidata-Item hinzukamen. Wer die Reihenfolge umdreht (Wikidata zuerst, Belege später), riskiert einen Löschantrag wegen fehlender Notability und hat in unseren Fällen mehrere Monate verloren. Eigene Beobachtung, keine repräsentative Stichprobe.
Die 8-Schritte-Anleitung zum Knowledge Panel: dokumentiert und erweitert
Die folgende Sequenz verbindet, was Googles Knowledge-Panel-Hilfe offiziell beschreibt, mit dem in der Entity-SEO-Branche verbreiteten Vorgehen. Jeder der acht Schritte wird hier im Originaltext-Kern zusammengefasst und anschließend mit operativen Details aus der eigenen Beratungspraxis erweitert, damit der Schritt nicht als Checkliste, sondern als funktionaler Baustein lesbar bleibt.
Schritt 1: Verstehen, was Google tatsächlich will
Google vergibt Panels nicht als Gefallen. Ein Panel erscheint, wenn der Knowledge Graph genug Konfidenz hat, dass eine distinktive, notable Entität vorliegt. Diese Konfidenz stützt sich auf drei Säulen: Corroboration (mehrere unabhängige, autoritative Quellen bestätigen dieselben Fakten), Authority (Wikipedia, große Nachrichtenmedien, Fachpublikationen und etablierte Datenbanken als Ankerpunkte) und Structured Data (Schema-Markup auf Websites, das die Entität maschinenlesbar definiert).
Erweiterung: Google selbst schreibt in seiner Knowledge-Panel-Hilfe, dass Panels automatisch aus Datenpartnern, offenen Webquellen und Vorschlägen verifizierter Entitäten entstehen. Die operative Konsequenz ist unbequem, aber eindeutig: Panels sind das Symptom eines Vertrauensgewinns, kein Kauf-Produkt. Wer am Panel zu arbeiten versucht, arbeitet am falschen Endpunkt der Wertschöpfungskette. Korrekt ist die Arbeit an den drei Säulen, aus denen die Konfidenz entsteht.
Schritt 2: Aktuelle Online-Präsenz auditieren
Vor jedem Aufbau steht die Bestandsaufnahme: Was sieht Google heute? Inkognito-Suche nach dem eigenen Vollnamen. Existiert bereits ein Panel? Was dominiert Seite 1: LinkedIn, die eigene Website, News, oder nichts Belastbares? Gibt es Namens-Kollisionen mit anderen Trägern desselben Namens? Sind die Daten über Plattformen hinweg konsistent oder widersprechen sie sich bei Rolle, Firma oder Ort?
Erweiterung: Neben der manuellen SERP-Prüfung liefern die Google Knowledge Graph Search API (laut Google nicht für produktionskritische Nutzung gedacht), SERP-Tools wie Ahrefs oder Semrush für das Brand-SERP-Monitoring sowie der Wikidata-Reconciliation-Service brauchbare Signale. Bing Entity Search fällt weg: Microsoft hat die Bing Search APIs am 11. August 2025 eingestellt. Name-Collision-Fälle, besonders bei häufigen türkischen Namen oder Allerweltsnamen, erfordern eine klare Disambiguation-Strategie: konsequent geführter Mittelname, akademischer Titel oder eine stabile Funktionsbezeichnung als Suffix.
Schritt 3: Die Entity-Home etablieren
Die Entity-Home ist die eine Seite, die Google als primäre Wahrheitsquelle über die Entität betrachtet, meistens die About-Seite der eigenen Website. Pflicht: Vollname im H1, eine professionell formulierte Bio (Wer, Was, Credentials, Affiliations), Links zu allen verifizierten Social-Profilen, ein hochwertiges Headshot und Schema.org Person mit Name, Jobtitel, Organisation, Social-Links und Bild.
Erweiterung: In 2026 reicht dieser Minimalumfang nicht mehr. Ergänzt werden sollten knowsAbout (Themen-Entitäten), alumniOf, award und hasCredential. Zudem muss die Seite unter einer stabilen, kanonischen URL liegen (Muster: /about/vorname-nachname/) und interne Links auf die knowsAbout-Zielseiten setzen. Das erzeugt Ko-Okkurrenz-Signale, die Google bei der thematischen Einordnung der Entität verarbeitet.
Schritt 4: Jedes Profil standardisieren
Google referenziert Informationen über Plattformen hinweg. Widersprüche wie „CEO at Acme Corp" (LinkedIn), „Founder, Acme" (Twitter) und „Managing Director, Acme Corporation" (Website) verwirren den Entity-Resolver. Standardisiert werden müssen: Name (gleiche Schreibweise, keine Abkürzungen), Titel, Firma, Kern-Bio-Fakten und Profilfoto. Typische Kandidaten: LinkedIn, X/Twitter, Instagram, Facebook, YouTube, Crunchbase, Bloomberg (wenn anwendbar), eigene Website, Firmen-Bio, Branchendirektorien, Podcast-Gastprofile und Speaker-Bios. In der Praxis kuratiert man daraus 7-10 starke Kernprofile und pflegt diese konsequent — also Stunden statt Minuten.
Erweiterung: Ein NAP-Register als strukturierte Tabelle (Google Sheet, CMDB, Notion-Datenbank) ist Pflicht, nicht Kür. Die Pflege läuft quartalsweise, flankiert von Namensmonitoring über Google Alerts und Mentionlytics. Jeder Drift-Fall wird nicht kommentiert, sondern an der Quelle korrigiert.
Schritt 5: Wikidata prüfen, nicht erzwingen
Wikidata ist das strukturierte Backbone hinter Wikipedia. Ein Wikipedia-Artikel ist nicht Voraussetzung für ein Knowledge Panel, ein verbreiteter Mythos. Ein Wikidata-Item ebenfalls nicht: Googles Hilfe nennt keine bestimmte Datenbank als Pflichtquelle. Ein regelkonformes Item kann die Faktenbasis aber stärken. Es wird auf wikidata.org angelegt, die Claims (Name, Geburtsdatum, Beruf, Arbeitgeber, Website, Social-Profile) werden jeweils mit Referenzen aus unabhängigen Sekundärquellen belegt; self-published Quellen werden in der Regel abgelehnt. Risiko: Wikidata-Editoren können das Item wegen fehlender Notability löschen, und ein gelöschtes Item verschlechtert die Ausgangslage. Items über sich selbst oder das eigene Unternehmen anzulegen, gilt laut Self-promotion-Essay als Selbstdarstellung und wird ausdrücklich nicht empfohlen.
Erweiterung: Vor dem Anlegen erfolgt ein Notability-Check gegen WD:Notability (gültiger Sitelink, oder klar identifizierbare Entität mit seriösen, öffentlich zugänglichen Quellen, oder struktureller Bedarf). Bei bezahlter Mitarbeit gilt die Offenlegungspflicht der Wikimedia-Nutzungsbedingungen. Properties konsequent pflegen: P31 (instance of), P106 (occupation), P108 (employer), P856 (official website), P2003 (Instagram), P2013 (Facebook), P2002 (X/Twitter), P496 (ORCID iD). Mehrsprachige Labels für alle Zielmärkte sind Standard, nicht Sonderfall.
Schritt 6: Presse und autoritative Erwähnungen aufbauen
Google braucht unabhängige Drittquellen, die die Fakten bestätigen. Die stärksten Signale: Fachartikel in Publikationen, denen Google vertraut (große Publikumsmedien, Branchenfachmedien), Interviews, Podcast-Features, Gastartikel, Branchendatenbanken (Crunchbase für Gründer, IMDb für Medienprofis), Berufsverbandslistungen. Nach unserer Erfahrung wiegt ein echtes Feature in einer Branchenpublikation mehr als viele Pressemitteilungen, weil nur redaktionelle Coverage eine unabhängige Bestätigung ist.
Erweiterung: Redaktionelle Coverage folgt dem Beitragswert-Prinzip: exklusive Daten, Primärforschung, pointierte Meinung. Zielmedien lassen sich nach Domain-Authority und redaktioneller Reichweite priorisieren. Gastbeiträge in fachlich einschlägigen Publikationen (für SEO-Themen etwa Search Engine Land, Search Engine Journal, t3n, OMR) bauen Topical-Authority parallel zur Entität auf und verankern die Person in der semantischen Nachbarschaft ihres Fachs.
Schritt 7: Technische SEO-Signale implementieren
Über die Entity-Home hinaus sind technische Signale Pflicht: sameAs-Properties im Schema, die auf alle verifizierten Profile zeigen; NAP-Konsistenz über alle Business-Listings; Google Search Console für die Website verifiziert; korrekte Crawlbarkeit (kein noindex auf Kernseiten). Sitelinks-Searchbox-Markup ist überflüssig geworden: Google zeigt das Sitelinks-Suchfeld seit dem 21. November 2024 nicht mehr an.
Erweiterung: Ergänzend wird Organization mit Person über worksFor verkettet, Article-Schema nutzt author-Referenz (@id) auf den Person-Knoten, ImageObject kommt als image-Property mit width, height und caption. Google Merchant Center und Google Business Profile sind zu verifizieren, falls anwendbar; Bing Webmaster Tools und Bing Places komplettieren die Maschinenlesbarkeit. Crawl-Budget: die Entity-Home muss eine niedrige Click-Tiefe haben, maximal zwei Klicks von der Startseite.
Schritt 8 - Warten (und hoffen)
Auch bei korrekter Ausführung gibt es keine Garantien. Google recrawlt und reverarbeitet nach eigenem Zeitplan. In unseren Projekten dauerte die Panel-Emergenz für manche Entitäten vier bis sechs Monate, für andere sechs bis zwölf. Name-Collisions oder unzureichende Authority können selbst nach vollständiger Umsetzung ein Panel verhindern. Shortcuts - spammiges Link-Building, Fake-Presse, gekaufte Wikipedia-Edits - können ein Panel kurz auslösen und dann zum Delete führen, und ein gelöschtes Panel ist deutlich schwerer wieder aufzubauen als ein nie erschienenes.
Erweiterung: Die Wartezeit ist kein passives Intervall, sondern eine aktive Verstärkungsphase. Sie umfasst Content-Produktion mit konsistenten Entity-Ko-Okkurrenzen, fortlaufende Pflege des Wikidata-Items, wöchentliches Tracking der Google-Knowledge-Graph-API-Antworten und kontrollierte Expansion der Drittquellen. Bleibt das Panel nach rund neun Monaten aus, folgt ein Notability-Re-Audit durch einen neutralen Dritten - in der Regel identifiziert dieser Audit präzise die Schicht (Corroboration, Authority oder Structured Data), auf der die Konfidenz unter Schwelle bleibt.
Das 6-Monats-Protokoll: Entity-Trust aufbauen statt Panel jagen
Das folgende Protokoll ist die verdichtete, monatlich getaktete Rollout-Version der acht Schritte oben - kondensiert für die Onboarding-Sequenz mit Personal Brands und mittelständischen Organisationen. Es ist bewusst monatlich strukturiert, nicht weil jeder Schritt einen Monat dauert, sondern weil die Reifungszeit zwischen den Schritten für Googles Crawl- und Verifikations-Zyklen notwendig ist.
- Monat 1 - Entity-Audit und Name-Collision-Check. Bestehenden Knowledge-Graph-Footprint prüfen (Google KG Search API, Search-Operator-Sampling). Name-Collision-Matrix aufstellen: alle Namensträger mit öffentlicher Sichtbarkeit, Gewichtung ihrer jeweiligen Entity-Trust-Scores. Disambiguation-Strategie festlegen (Mittelname verwenden, akademischen Titel konsistent führen, Berufsbezeichnung als Suffix etablieren).
- Monat 2 - Schema.org Person/Organization implementieren. Person- oder Organization-Schema mit vollständigem sameAs-Cluster auf der eigenen Domain ausrollen. Dedizierte Personenseite (
/about/max-muster/) mit@id-Anker. Parallel NAP-Daten auf 7-10 kuratierten, autoritativen Profilen spiegeln. Jedes Profil: gleiches Foto, gleicher Name, gleiche Rolle, gleicher Firmen-Link. - Monat 3 - Wikidata-Fundament prüfen. Notability nach WD:Notability prüfen. Nur wenn unabhängige, seriöse Quellen die Entität belegen, ein Item anlegen (lassen), idealerweise durch unabhängige Editoren; eigenes oder bezahltes Interesse offenlegen. Referenzen hinterlegen, Properties sauber pflegen (P31, P106, P1416, P856). Externe IDs (ORCID, LinkedIn-URL, Crunchbase) verknüpfen. Mehrsprachige Labels für relevante Märkte ergänzen.
- Monat 4 - Corroboration über autoritative Medien. Mindestens drei unabhängige Fachmedien mit konsistenten Fakten (Rolle, Firma, Ort, Laufbahn). Kein Pay-for-Placement. Fokus auf Branchenpublikationen mit redaktioneller Substanz und eigenem Schema.org-Author-Block.
- Monat 5 - Authority-Signale verdichten. Speaker-Rollen auf Konferenzen, Gremien-Mitgliedschaften, Autorenschaft in Fachzeitschriften, Zitationen in Studien. Jedes Signal mit maschinenlesbarem Fingerabdruck - Referentenprofile mit Author-Schema, Podcast-Einträge mit strukturierter Gästeliste, GitHub-/ORCID-/Google-Scholar-Verknüpfungen.
- Monat 6 - Monitoring und Entity-Drift-Kontrolle. Quartalsweise Google-Knowledge-Graph-API-Check. Monitoring von Drittanbieter-Datenbanken auf fehlerhafte Fakten. Bei Entity-Drift (falsches Foto, veraltete Position, Namens-Kollision) kontrollierte Korrektur über Quell-Update - nie über Panel-Feedback-Formular allein.
Das Protokoll ist bewusst frei von „Panel-Trigger-Tricks". Jeder Schritt adressiert eine der sechs Trust-Schichten. Wenn das System hält, erscheint das Panel als Nebenprodukt. Wenn es nicht erscheint, ist das diagnostisch wertvoll: Eine Schicht ist schwach, und der Audit zeigt, welche.
Grenzen, Risiken und ehrliche Erwartungen
Kein Protokoll garantiert ein Panel. In unserer Beratungspraxis erschien in der Mehrheit der sauber umgesetzten Cases ein Panel; die Fälle ohne Panel-Emergenz teilen sich in zwei Gruppen: unzureichende Notability (keine belastbaren Sekundärquellen im Sinne der Wikidata-Kriterien) und hohe Name-Collision mit bereits etablierten Trägern desselben Namens, bei denen Disambiguation mehr Zeit benötigt als das Beobachtungsfenster.
Ehrlicher als die „Garantie"-Rhetorik ist die Erwartungsformulierung: Ein sauberes Protokoll hebt die Panel-Wahrscheinlichkeit von einem sehr niedrigen Ausgangsniveau auf ein qualitativ belastbares Niveau, in unseren Projekten mit einem Zeitfenster von mehreren Monaten bis zu rund einem Jahr. Präzisere Zahlen ohne kontrollierte Studienbasis sind Marketing. Der reale Mehrwert liegt sekundär: Auch wenn kein Panel entsteht, verbessert die Arbeit nach unserer Beobachtung die Grundlage für KI-Zitate (siehe Prompt-Level-SEO) und für die Sichtbarkeit in AI Overviews.
Reputations-Kopplung: Panel und LLM-Vertrauen laufen parallel
Ein strategischer Nebeneffekt wird oft übersehen. Der Entity-Trust-Aufbau, der das Panel als Nebenprodukt erzeugt, erhöht gleichzeitig die Wahrscheinlichkeit, dass LLMs (ChatGPT, Claude, Gemini, Perplexity) die Entität korrekt modellieren und in Antworten zitieren. Wikipedia ist nachweislich Teil solcher Trainingsdaten: Bei GPT-3 stammten laut OpenAI-Paper (Brown et al., 2020) 3 % des Trainingsmix aus der englischsprachigen Wikipedia, die mit rund 3,4 Durchläufen häufiger gesehen wurde als jede andere Quelle. Welche strukturierten Quellen aktuelle Modelle nutzen, legen die Anbieter meist nicht offen. Der Knowledge-Graph-Aufbau wirkt deshalb häufig auch auf LLM-Antworten.
Für Senior-Brands heißt das: Das Budget für Entity-Trust-Arbeit wird zweifach verzinst - in Google-Sichtbarkeit (Panel, AI Overviews, Knowledge-Graph-basierte Features) und in LLM-Sichtbarkeit (korrekte Fakten in generativen Antworten, weniger Verwechslungen; eigene Daten dazu im Entity-Resolution-Pilot). Operativ flankieren wir diese Arbeit mit Online-Reputation-Management, siehe die Leistungsseite Online Reputation.
Fazit: Die Frage, die Sie stattdessen stellen müssen
Nicht: „Wie bekomme ich ein Knowledge Panel?" Diese Frage produziert Shortcuts, die nur kurz halten und danach den Re-Entry für einen erheblich längeren Zeitraum blockieren. Sondern: „Wie stabil ist meine Entität im Weltmodell, das Google aus Wikidata, autoritativen Quellen und strukturierten Daten rekonstruiert - und was fehlt ihr noch, um eindeutig zu sein?"
Diese zweite Frage ist unbequem, weil sie Arbeit verlangt, die nicht als Panel sichtbar wird, sondern als Fundament. Aber sie ist die Frage, die am ehesten zu einem stabilen Panel führt - als Nebenprodukt, nicht als Ziel. Wer sie konsequent beantwortet, baut mehr als ein Knowledge Panel: eine Entität, die Google, Bing, ChatGPT, Claude und Gemini mit deutlich höherer Wahrscheinlichkeit konsistent korrekt darstellen. Das ist kein Feature. Das ist strategisches Terrain.
Quellen
- Knowledge Panels (Infobox-Hilfe), Google, abgerufen September 2026
- Identität auf Google bestätigen (Infobox-Hilfe), Google, abgerufen September 2026
- Introducing the Knowledge Graph: things, not strings, Google Blog, Amit Singhal, 16. Mai 2012
- Knowledge Graph Search API, Google for Developers, abgerufen September 2026
- Farewell, Sitelinks Search Box, Google Search Central Blog, 21. Oktober 2024
- Bing Search APIs Retiring on August 11, 2025, Microsoft Learn, Mai 2025
- Wikidata:Notability, Wikidata, abgerufen September 2026
- Wikidata:Self-promotion (Essay), Wikidata, abgerufen September 2026
- Terms of Use, Abschnitt zu bezahlten Beiträgen, Wikimedia Foundation, gültig seit 7. Juni 2023
- From Freebase to Wikidata: The Great Migration, Pellissier Tanon et al., WWW 2016, 2016
- Language Models are Few-Shot Learners, Brown et al., arXiv, 2020